
Tu modelo no se cae a las 3 a.m. por mala suerte. Se cae porque nadie lo está mirando.
Son las 3:07 de la madrugada. Suena el teléfono. Es el canal de alertas. El dashboard de negocio muestra conversiones por el suelo, el equipo de soporte está despertando, y tú, que entrenaste ese modelo hace ocho meses con un AUC de 0.94 que te hizo sentir invencible, tienes que explicar en una reunión de emergencia por qué el sistema lleva tres semanas tomando decisiones basura sin que nadie se diera cuenta.
¿Te suena? Bienvenido al club. El club de los que descubrieron que entrenar un modelo es el 10% del trabajo y mantenerlo vivo en producción es el otro 90%.
Hoy te voy a contar cómo evitar esa llamada. Y lo vamos a hacer con herramientas open source, sin contratos corporativos ni dashboards que cuestan más que tu salario. Pero primero, entendamos al enemigo.
El enemigo silencioso: el mundo cambia, tu modelo no
Un modelo de machine learning es como una foto del mundo en el momento en que lo entrenaste. Si entrenaste un modelo de riesgo crediticio en 2023, ese modelo entiende el mundo de 2023. Pero el mundo de 2026 tiene otros hábitos de consumo, otras tasas, otra inflación, otra estacionalidad post-pandemia que nadie vio venir.
A eso le llamamos drift. Y hay dos tipos que te van a arruinar la noche:
-
Data drift (o covariate shift): las variables de entrada cambian su distribución. Imagina que entrenaste un modelo de precios de renta con datos de una ciudad donde el metro cuadrado costaba X. De repente llega una ola de inversión extranjera y los precios se duplican. Tu modelo sigue asumiendo el mundo viejo. Resultado: predicciones ridículas.
-
Concept drift: la relación entre las variables y el target cambia. Este es más cabrón porque no se ve en las entradas. El ejemplo clásico: un modelo de detección de fraude entrenado antes de que existieran las billeteras digitales. Los patrones de fraude cambiaron, pero las variables de entrada siguen viéndose iguales. Tu modelo no sabe que el mundo cambió de reglas.
Y aquí viene la parte que duele: el drift no avisa. No hay un log de error. No hay un stack trace. El modelo sigue respondiendo en 50 milisegundos, tan feliz, dando respuestas cada vez más equivocadas.
La trampa del accuracy en producción
Aquí va mi opinión impopular: medir accuracy en producción es casi inútil en la mayoría de casos reales.
¿Por qué? Porque para medir accuracy necesitas las etiquetas reales. Y las etiquetas reales en producción llegan tarde. A veces días, a veces semanas. Si estás prediciendo si un usuario va a cancelar su suscripción, no vas a saber si acertaste hasta que efectivamente cancele o renueve. Para entonces, ya tomaste mil decisiones con un modelo que quizás llevaba un mes desviado.
Entonces, ¿qué mides mientras esperas las etiquetas? Mides distribuciones. Mides comportamiento. Mides proxies.
Y ahí es donde entran las herramientas open source que te van a salvar el pellejo.
Tu caja de herramientas para no morir en el intento
No necesitas una plataforma enterprise de observabilidad que cuesta como un departamento. Necesitas tres cosas: detectar drift, monitorear performance proxy, y alertar antes de que el negocio se caiga.
1. Detección de drift estadístico
La idea es simple: comparas la distribución de tus variables en producción contra la distribución de referencia (tus datos de entrenamiento o una ventana reciente estable). Si la distancia es grande, alerta.
Herramientas open source que hacen esto de maravilla:
- Evidently: mi favorita para empezar. Te genera reportes HTML con tests estadísticos (Kolmogorov-Smirnov, chi-cuadrado, PSI) por cada columna. En cinco líneas de código tienes un reporte de drift. Y lo puedes correr como parte de tu pipeline.
- Alibi Detect: más orientada a detección online y a drift en embeddings, ideal si trabajas con texto o imágenes.
- NannyML: su fuerte es estimar performance sin etiquetas. Sí, leíste bien. Usa técnicas como CBPE (Confidence-Based Performance Estimation) para estimar cómo va tu modelo aunque no tengas el ground truth todavía.
2. Monitoreo de performance proxy
Mientras esperas etiquetas, mide cosas que correlacionen con el desempeño:
- Distribución de las predicciones (¿de repente tu modelo predice 90% clase positiva cuando antes era 50/50? Red flag gigante).
- Confianza del modelo (si tu modelo devuelve probabilidades, mira cómo se mueven).
- Tasa de valores nulos o fuera de rango en las entradas.
- Latencia y throughput (no es drift, pero te avisa de problemas de infraestructura).
3. Alertas que no te despierten por nada
Aquí va un consejo de guerra: no alertes por cada test estadístico que falle. Vas a terminar ignorando las alertas, y eso es peor que no tenerlas.
Define umbrales con contexto de negocio. Un drift en la variable "edad" puede ser irrelevante. Un drift en la variable "monto de transacción" en un modelo de fraude es una emergencia. Prioriza.
Un pipeline mínimo viable (y realista)
Te dejo un esqueleto que puedes montar esta misma semana:
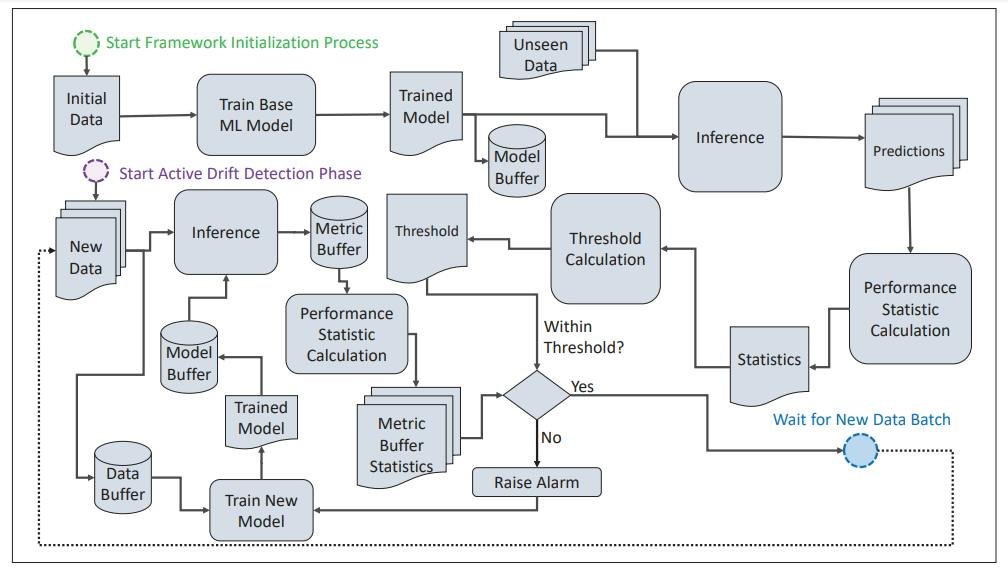
- Guarda tus datos de referencia. Al entrenar, guarda una muestra representativa de las features de entrada y las predicciones. Sin esto, no hay comparación posible.
- Loggea cada predicción en producción. Features de entrada + predicción + timestamp + versión del modelo. Un simple archivo Parquet o una tabla en tu base de datos sirve.
- Corre un job periódico (cada hora, cada día, depende de tu caso) que compare la ventana reciente contra la referencia usando una librería de drift.
- Calcula un score de drift agregado y define umbrales por variable crítica.
- Alerta solo cuando se crucen umbrales de negocio. No cuando el test estadístico diga "p < 0.05" en una variable que da igual.
- Documenta qué hacer cuando salte la alerta. ¿Reentrenar? ¿Rollback a versión anterior? ¿Escalar a humano? Si no tienes playbook, la alerta es solo ruido.
El error que casi todos cometemos
Pensar que el monitoreo es un proyecto que se hace una vez y ya. No. El monitoreo es un sistema vivo. Las variables que importan cambian, los umbrales se recalibran, las alertas se afinan. Es como cuidar una planta: no la riegas una vez y esperas que sobreviva un año.
Y otro error: monitorear solo el modelo. Monitorea también los datos de entrada, el pipeline de features, y el sistema que consume las predicciones. A veces el modelo está perfecto y lo que se rompió fue el ETL que alimenta las features.
Por qué esto te importa (aunque no seas MLOps)
Vivimos rodeados de modelos. El filtro de spam, la recomendación de tu serie, el scoring de tu crédito, el triaje en urgencias, la predicción de demanda de tu supermercado. Cuando uno de estos se desvía en silencio, alguien paga el precio: un correo importante en spam, una serie que no ves, un crédito negado injustamente.
El monitoreo de drift no es un lujo de equipos grandes. Es la diferencia entre un modelo que aporta valor y un modelo que se convierte en deuda técnica silenciosa.
Y la buena noticia: con herramientas open source y un poco de disciplina, puedes montar un sistema decente sin pedir presupuesto a nadie. Yo lo he hecho con un cron job, una librería de drift y un canal de Slack. No es glamuroso, pero me ha salvado más de una noche.
Así que la próxima vez que entrenes un modelo y lo subas a producción, pregúntate: ¿quién va a estar mirando cuando yo esté durmiendo?
Si la respuesta es "nadie", ya sabes lo que toca. Y si ya tienes tu sistema de monitoreo montado, cuéntame:
Comentarios
Deja un comentario